연립방정식에서 셀프 어텐션까지
2026.10.03행렬, 선형변환, 셀프 어텐션
연립방정식에서 출발해 행렬곱과 선형변환을 이해하고, 그것이 셀프 어텐션의 계산으로 이어지는 과정까지 정리한 내용.
(Claude Sonnet 5.5와 대화하며 이해한 과정을, Claude Sonnet 5.5가 글로 옮겨 작성함)
큰 줄기
이 글은 네 계층으로 이어진다.
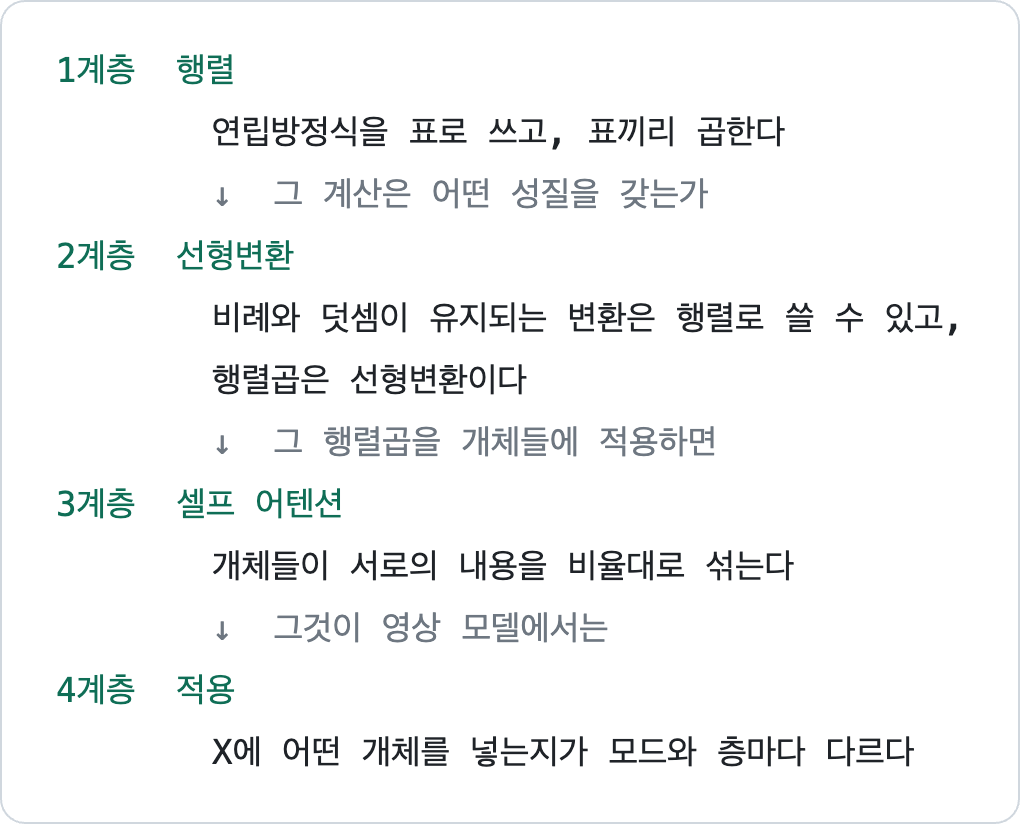
1. 행렬: 연립방정식에서 행렬곱까지
1-1. 연립방정식을 행렬로 표현
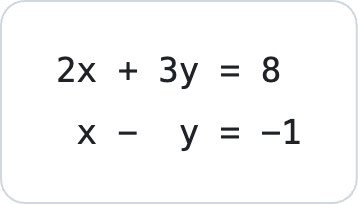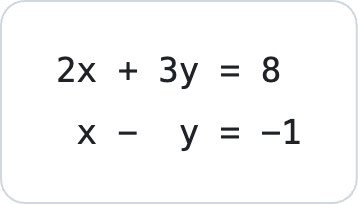
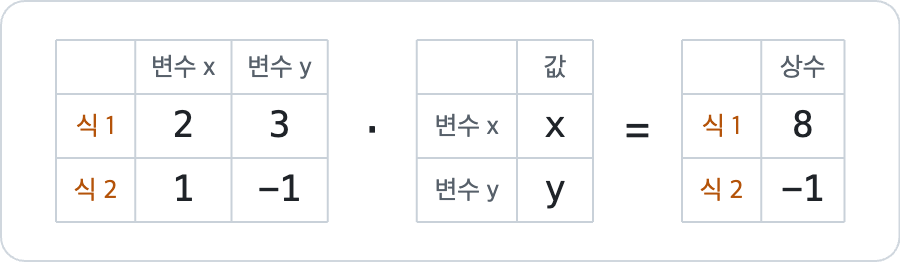
**계수:** 변수 앞에 곱해지는 값
**행:** 방정식 하나
**열:** 변수 하나 (x, y 순서)
곱셈은 **왼쪽의 행 하나와 오른쪽의 열 하나를 원소끼리 곱해서 더한 값**이 결과의 한 칸이 된다.
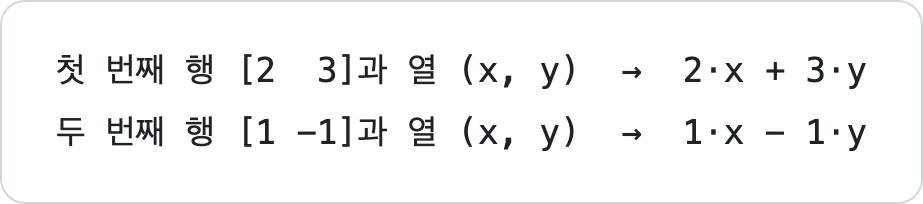
연립방정식의 좌변을 계산하는 과정 그대로이다. 그래서 **Ax = b**로 쓴다.
1-2. 좌우 행렬의 차이
**왼쪽 행렬:** 식(계수). **열**이 변수 순서이다.
**오른쪽 행렬:** 값. **행**이 변수 순서이고, **열**은 값 세트 하나이다.
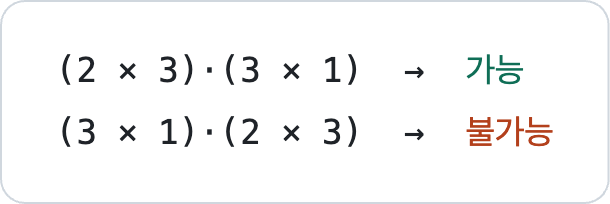
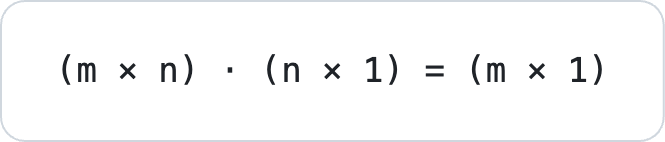
둘 다 변수 개수가 같아야 곱할 수 있다. **(a × b) · (b × c) = (a × c)**
(x = 1, y = 2)와 (x = 4, y = 0)을 한 번에 넣으면 다음과 같다.
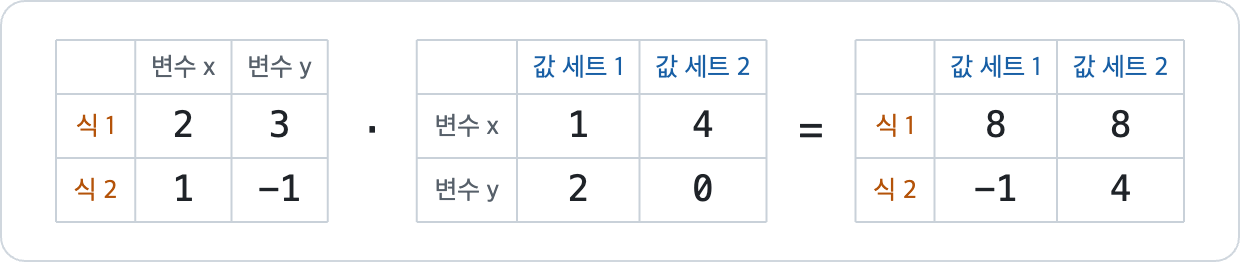
결과의 열 하나가 값 세트 하나를 식에 넣은 결과이다.
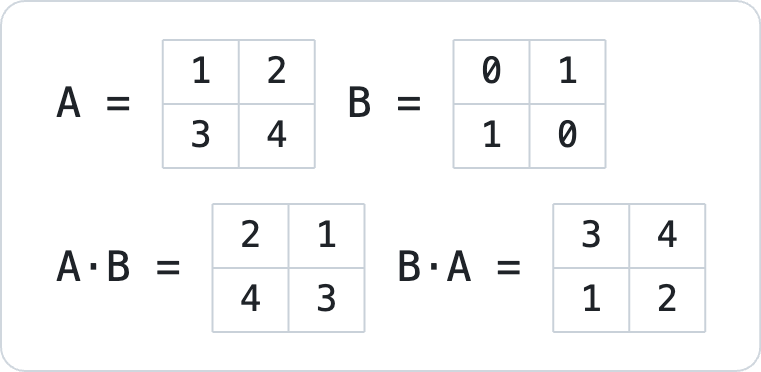
좌우를 바꾸면 크기가 맞지 않거나, 맞아도 결과가 다르다.
A = [[1, 2], [3, 4]], B = [[0, 1], [1, 0]]일 때 A·B와 B·A는 다음과 같이 다르다.
1-3. 벡터의 길이가 바뀌는 이유
벡터의 값 n개를 변수 자리에 넣고 방정식이 m개이면, 결과도 m개이다.
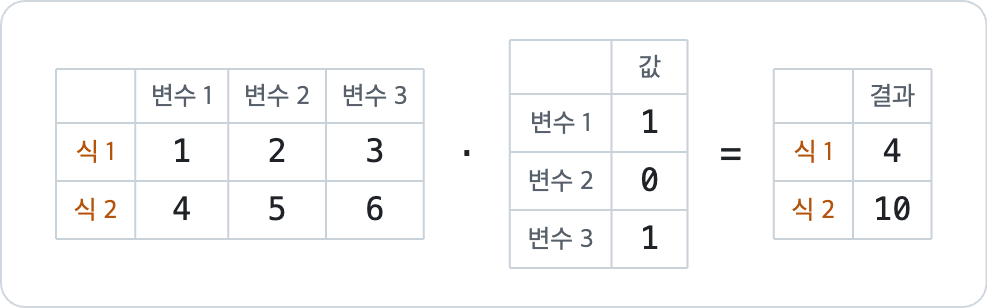
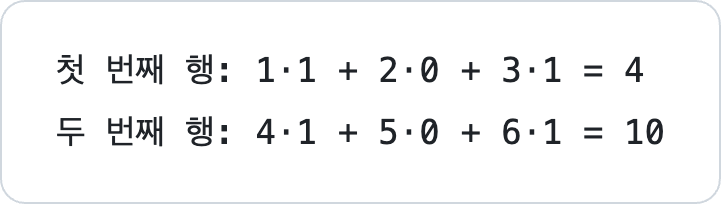
길이 3인 벡터가 길이 2인 벡터가 되었다.
벡터를 행벡터로 왼쪽에 놓으면 (1 × n) · (n × m) = (1 × m)이고, 같은 변환의 행렬은 n × m으로 뒤집힌(전치된) 모양이 된다.
2. 선형변환: 그 계산이 갖는 성질
2-1. 왜 쓰는가
연립방정식의 좌변은 **a·x + b·y 꼴**이다. 이 꼴은 비례와 덧셈이 유지된다. 이것이 **선형변환**이다.
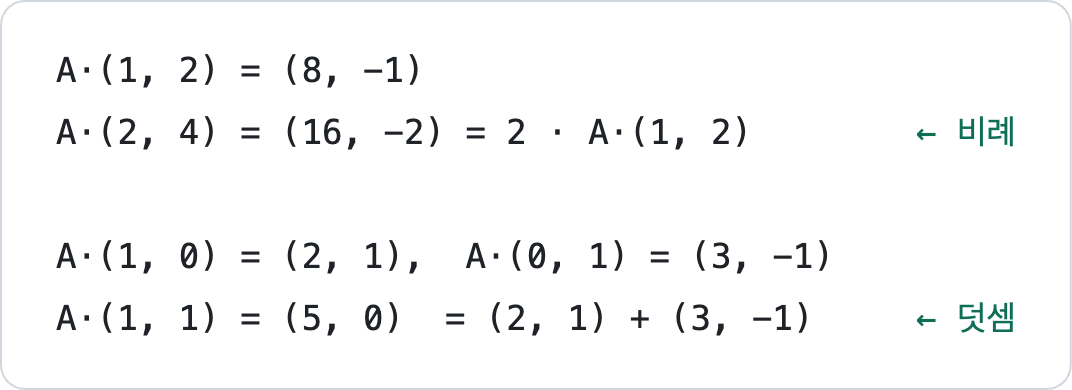
선형이 아닌 예는 벡터의 길이이다. 비례는 되지만 덧셈이 깨진다.
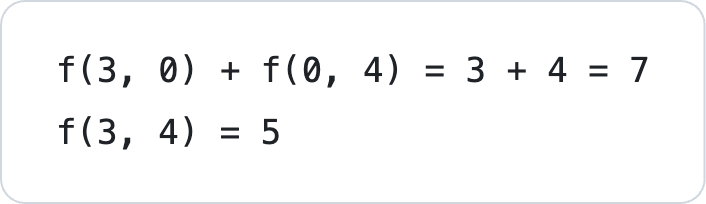
정규화(길이를 1로 만듦)와 x + 1 같은 이동도 선형이 아니다.
2-2. 선형변환과 행렬
선형변환은 a·x + b·y 꼴을 줄마다 쌓은 것이고, 그 계수만 모은 표가 행렬이다.
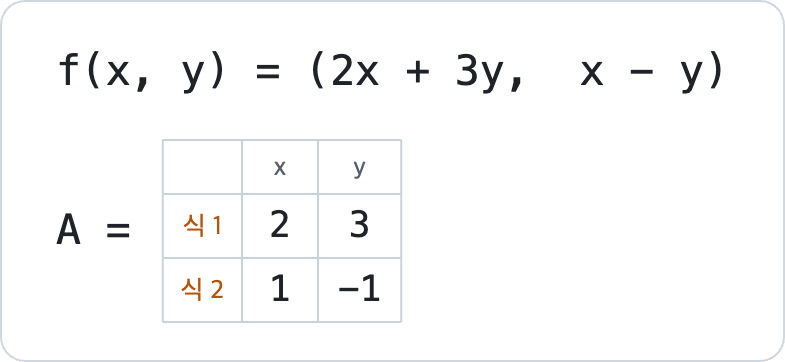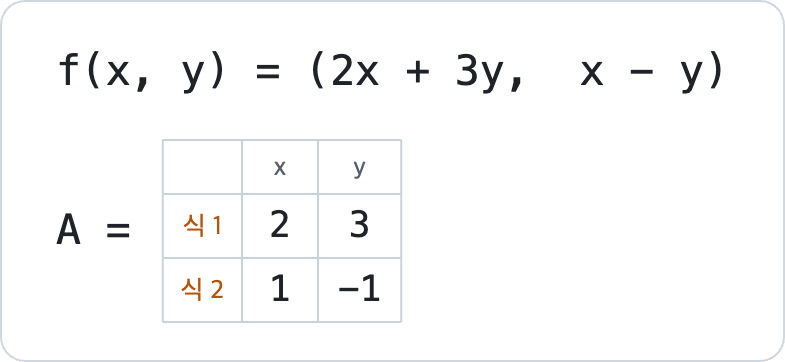
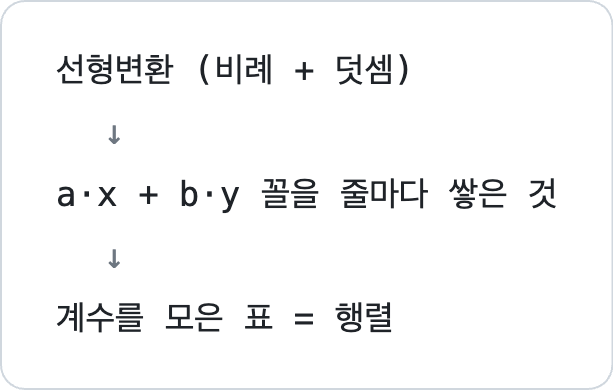
**행렬 자체가 선형변환이다.**
3. 셀프 어텐션: 행렬곱으로 개체를 섞는다
3-1. 행렬의 행과 열: 개체와 데이터
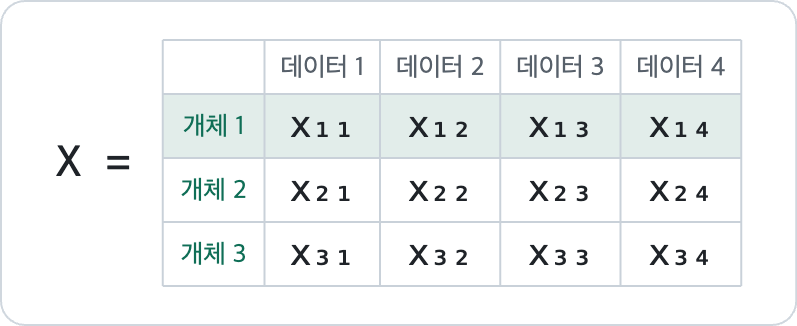
AI에서 다루는 뿌리 행렬 X는 다음과 같이 읽는다.
**행:** 개체 하나 (영상의 한 조각, 글의 토큰 하나)
**열:** 그 개체를 구성하는 데이터
개체가 N개이고 데이터가 d개이면 X는 N × d 행렬이다. 1계층과 2계층의 식은 이 개체 하나의 데이터를 변환하는 계산에 해당한다. (개체 3개, 데이터 4개는 설명용이다.)
1-3의 곱을 X 전체에 적용하면 다음과 같다.
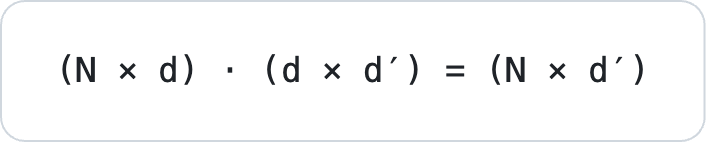
N개의 행이 같은 가중치 행렬을 각각 곱해서 변환되고, **행끼리는 섞이지 않는다.** 행의 의미(개체)는 그대로이고, 열은 새로운 d′개의 데이터가 된다.
행벡터를 왼쪽에 놓는 표기이므로, 왼쪽의 X가 값(입력)이고 오른쪽의 가중치 행렬이 식(계수)이다. 1-1과는 좌우 역할이 반대이다.
3-2. Q, K, V
X에 서로 다른 가중치 행렬을 곱해서 Q, K, V를 만든다.
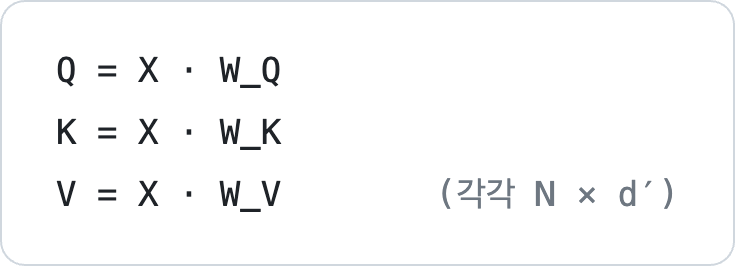
세 행렬 모두 같은 X에서 나왔으므로 **i번째 행은 모두 i번째 개체**이다. Q와 K는 개체들의 관계를 어느 정도로 할지 계산하는 데 쓰이고, V는 3-5에서 쓰인다.
3-3. Q와 K의 전치를 곱하면
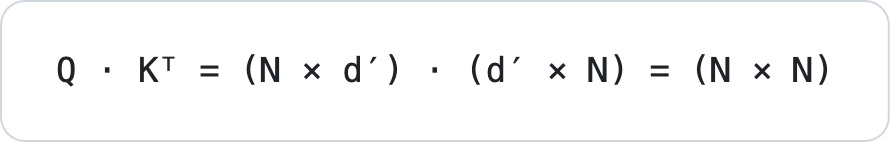
K를 전치하는 이유는 크기 규칙이다. (N × d′)·(N × d′)는 안쪽이 맞지 않아 곱할 수 없지만, 전치하면 안쪽이 d′로 같아진다.
**Q의 행:** 개체 하나
**Kᵀ의 열:** 개체 하나 (K의 행이 전치되어 열이 된 것)
Q의 행 하나는 Kᵀ의 **모든 열**과 연산된다. 따라서 결과 R의 행 i는 **개체 i가 모든 개체(자기 자신 포함)와 연산한 결과 N개**로 구성된다.
R의 행은 개체이지만, **R의 열 j는 개체 j 자체가 아니라 개체 j를 얼마나 반영할지에 대한 점수**이다. (Kᵀ의 열은 개체 j의 데이터이므로 개체가 맞다.)
연립방정식으로 읽으면 Q의 행이 식이고 Kᵀ의 열이 값 세트이다. (개체 3개, d′ = 2, 지어낸 값)
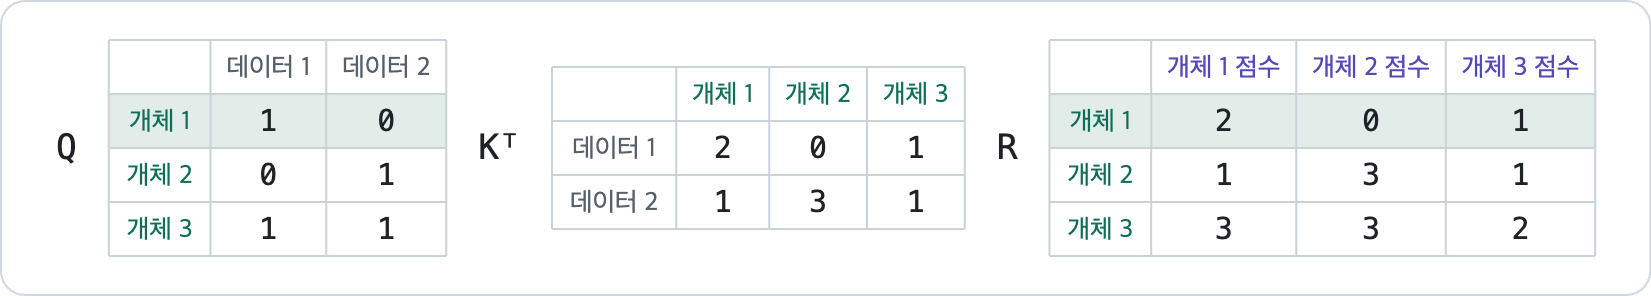
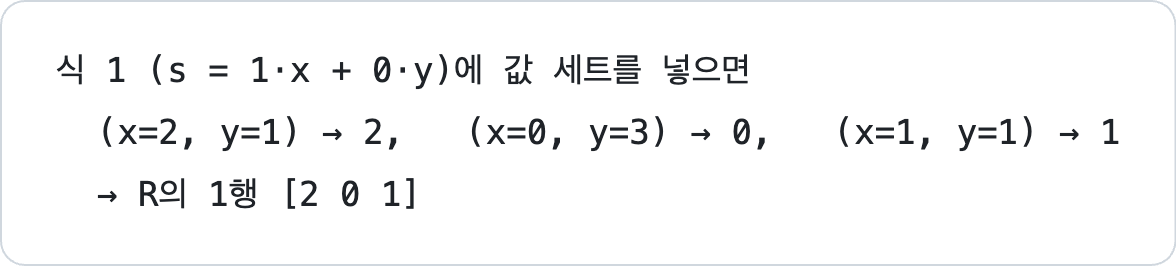
Q와 K가 같은 X에서 나왔기 때문에 개체들이 자기들끼리 서로 비교된다. 이것이 **셀프 어텐션의 1단계**이다. 이 곱은 입력끼리 곱해지는 연산이라, 2계층에서 정리한 선형이 아니다.
3-4. softmax
R의 각 행에 softmax를 적용한다. 한 행의 값들에 e^s를 취해 모두 0보다 크게 만든 뒤, 그 합으로 나눈다. 결과는 **행마다 합이 1**이 된다. 점수 차이가 클수록 비율의 차이는 더 벌어진다.
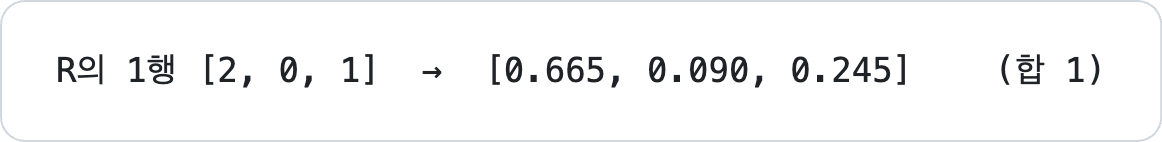
변환된 R2의 행은 개체 i이고, **R2의 열 j는 개체 j에서 가져올 비율**이다. 한 행(개체)이 가진 N개의 비율을 모두 더하면 1이다. 2-1의 "길이를 1로 만드는 정규화"와는 다른 정규화이고, 이것도 선형이 아니다.
3-5. V와 섞기
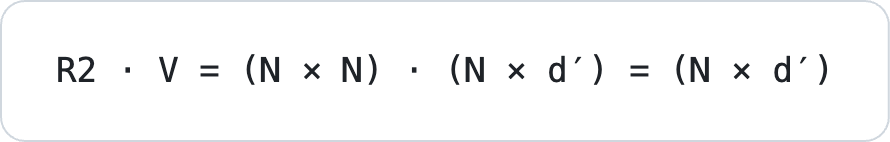
R2에는 "얼마나"만 있고 "무엇을"이 없다. 가져올 내용은 V에 있고, V의 행 j는 개체 j가 내어줄 내용이다.
**R2의 행 i:** 개체 i
**R2의 열 j:** 개체 j에서 가져올 비율
**V의 행 j:** 개체 j의 내용
**V의 열 c:** 모든 개체의 c번째 데이터
연립방정식으로 읽으면 계수는 R2의 행(합 1)이고, 변수는 N개의 개체이다.

R2, V, 새 행렬을 표로 쓰면 다음과 같다. (개체 3개, d′ = 2, 지어낸 값)
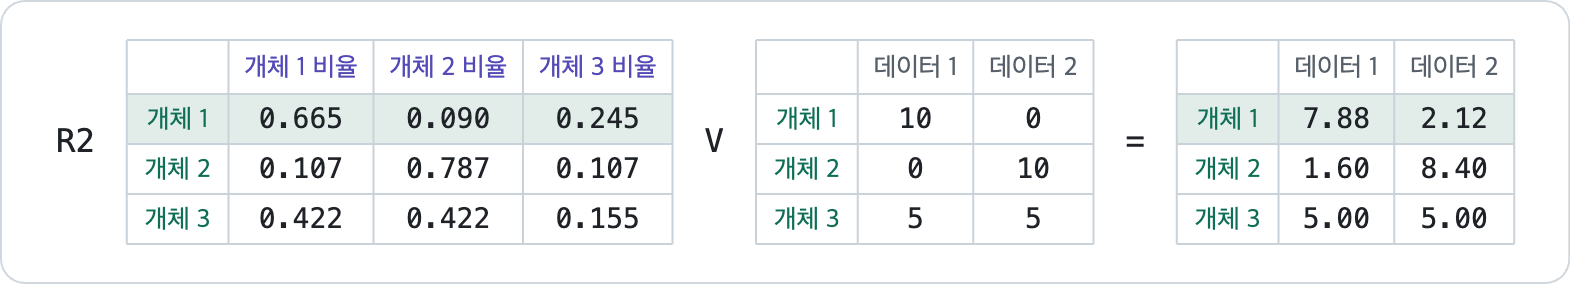
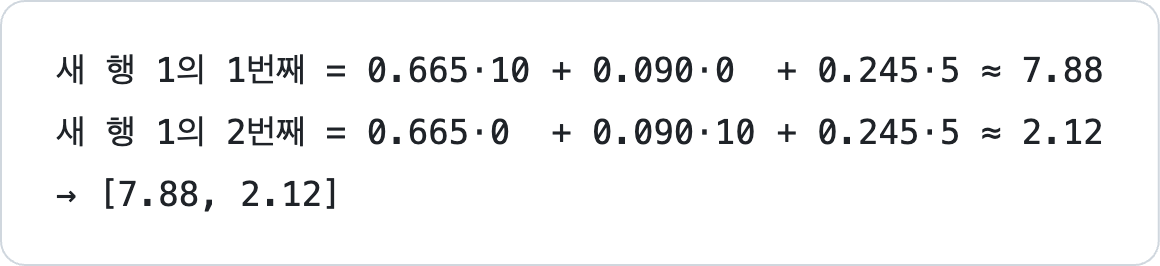
비율의 합이 1이므로 개체들의 내용을 비중을 달리해 평균 낸 것이다. 결과는 **개체마다, 다른 개체들의 내용이 비율대로 섞인 d′개의 데이터로 구성된 행**이다.
의미가 맞아떨어지는 이유는 크기 규칙에 있다. R2의 열 j(개체 j에서 가져올 비율)와 V의 행 j(개체 j의 내용)가 같은 개체 j끼리 짝지어 곱해진다. "안쪽 크기가 같아야 곱할 수 있다"는 규칙이 곧 **같은 개체끼리 짝짓는다**는 규칙이 된다.
3-6. 정리
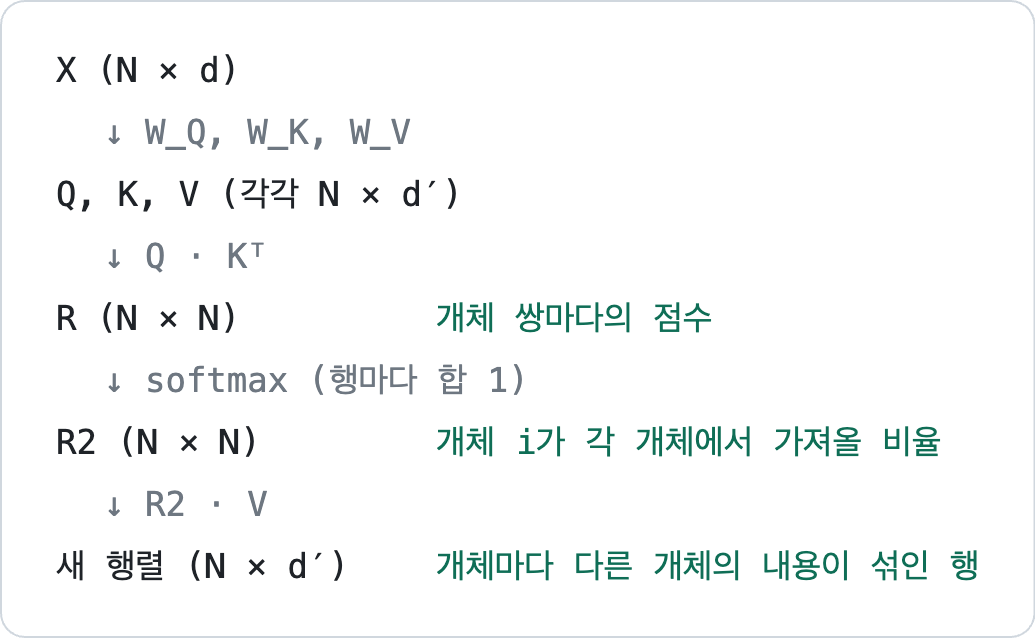
Q, K, V가 모두 같은 X에서 나오기 때문에 **셀프 어텐션**이다.
4. 적용: 영상 모델에서
이 공부는 영상 생성 모델 Seedance를 더 잘 쓰기 위해 내부 동작을 알아보면서 시작했다. 지금까지의 X, Q, K, V가 영상 모델에서 어떻게 쓰이는지 정리한다. Seedance 1.0 기술 보고서에서 확인한 내용은 [1.0 보고서], 확인하지 못한 추론은 [추론]으로 표시한다. Seedance 2.5의 내부 구조는 내가 찾은 자료에서 확인하지 못했다.
4-1. 클립은 X에 어떻게 들어가는가
출력 칸 개체는 처음에는 노이즈이고, 글·이미지·클립 개체를 참고해서 고쳐진다. 클립을 넣는 방식은 두 가지다.
**참조 모드:** 클립 칸이 별개의 **개체(행)** 로 X에 쌓인다.
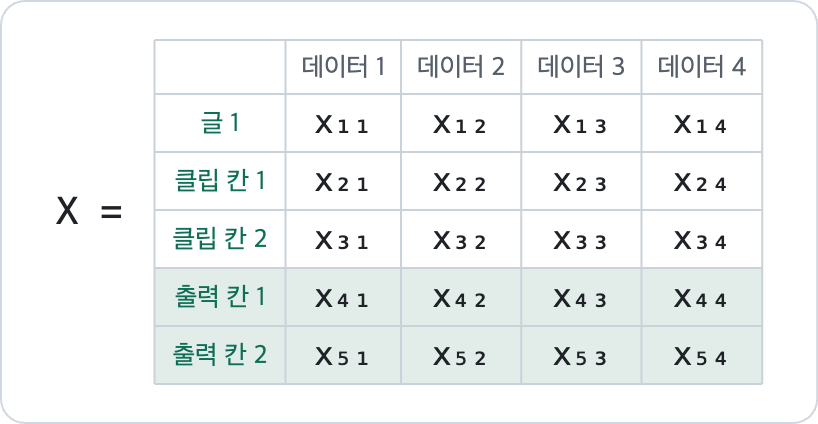
R의 열에 클립 칸이 생기고, 출력 칸 개체가 R2의 비율만큼 클립 칸의 V를 가져간다. 얼마나 가져갈지는 점수가 정하고, 그대로 지킬 의무는 없다.
**편집 모드:** 클립 칸이 개체가 되지 않는다. 같은 자리 출력 칸 개체의 **데이터(열)** 안에 붙는다.
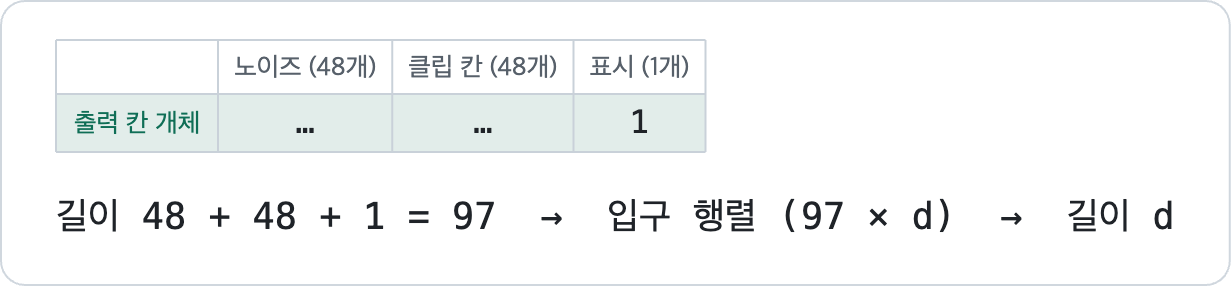
클립이 R을 거치지 않고 출력 개체 자체의 데이터로 들어간다. 표시 1은 "이 자리는 주어진 것"이라는 뜻이다. [1.0 보고서: 노이즈 입력에 정리된 프레임을 채널 방향으로 이어 붙이고, 이진 마스크로 따를 프레임을 표시한다] 2.5의 편집 모드가 이 방식이라는 것은 [추론]이고, 길이 48 / 48 / 1은 [추정]이다.
그래서 편집 모드에서는 클립이 그대로 남기 쉽고, 참조 모드에서는 클립이 다시 그려질 수 있다. 내 테스트(클레이 프리비즈)에서도 편집 모드는 입력 클립의 질감이 그대로 남았다.
4-2. 한 X에 누구를 같이 넣는가
개체가 수만 개이면 R(N × N)이 너무 커진다. 그래서 층마다 한 X에 넣는 개체를 제한한다. [1.0 보고서: 공간 층은 프레임 안에서, 시간 층은 프레임 사이에서 어텐션을 하고, 글 토큰은 공간 층에만 참여한다]
계산(Q, K, V → R → R2 → 섞기)은 그대로이고, **X에 누구를 넣느냐**만 층마다 다르다. 프레임 2개, 자리 3개짜리 작은 영상이면 칸이 6개다. (지어낸 예)
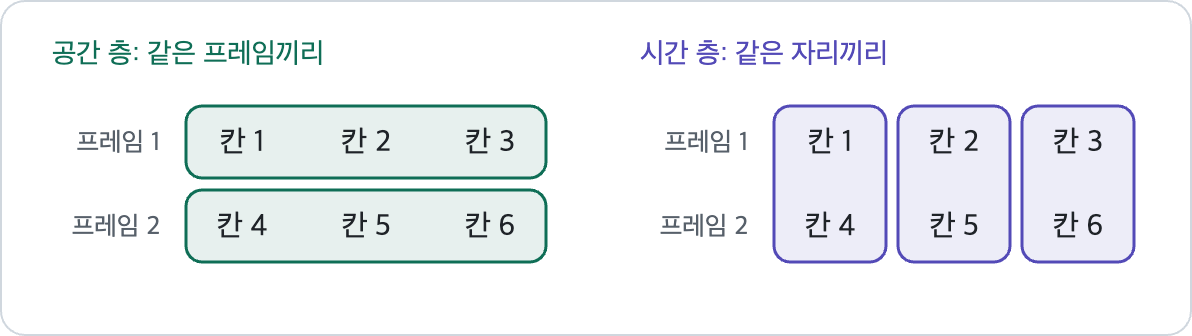
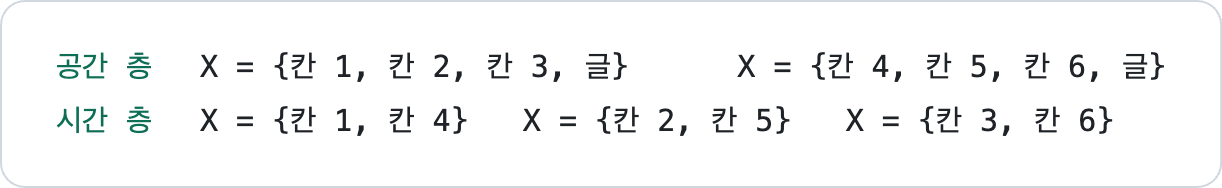
공간 층에서 칸 1은 칸 4에게서 받지 못하고, 시간 층에서 칸 1은 칸 2에게서 받지 못한다. 두 층을 번갈아 지나야 칸 1이 칸 5의 영향을 받는다. 시간 층의 "같은 자리끼리"는 창 분할을 단순화한 그림이고, 창의 크기는 확인하지 못했다.
생략한 것
실제 모델에는 이 글에서 뺀 것들이 더해진다.
점수를 √d′로 나누는 것, 위 과정을 여러 벌 나란히 하는 multi-head
**위치:** 개체의 위치 정보를 따로 준다. 영상은 칸마다 (프레임, 세로, 가로) 번호가 있고, Q와 K의 각 행을 그 자리만큼 **회전**시켜서 R이 자리 차이를 볼 수 있게 한다. V는 돌리지 않는다. [1.0 보고서: 영상 칸에는 3D RoPE]
**반복:** 층을 다 지난 뒤 출력 칸 개체만 꺼내 길이 48로 되돌려 출력 칸을 조금 고치고, 글·시트·클립은 그대로 두고 다시 쌓아서 처음부터 반복한다. 1.0은 이 값으로 velocity(속도)를 예측한다. [1.0 보고서: flow matching, velocity prediction] 스텝 수와 2.5의 방식은 확인하지 못했다.